Latches w OpenEdge

Współczesne systemy bazodanowe muszą obsługiwać setki, a nawet tysiące użytkowników wykonujących operacje w tym samym czasie. Wydajność bazy danych przy tak dużym obciążeniu zależy nie tylko od mocy procesora, ilości pamięci RAM czy szybkości dysków, ale przede wszystkim od wydajnego zarządzania współbieżnością (concurrency).

W silniku bazy OpenEdge RDBMS procesy stale dzielą między sobą dostęp do wewnętrznych struktur pamięci współdzielonej (Shared Memory) – takich jak bufory danych, tablice mieszające czy kolejki transakcji. Aby uniknąć uszkodzenia danych i zapewnić spójność pamięci, silnik musi kontrolować, który proces i w którym momencie może zmodyfikować dany zasób.

Do zabezpieczania tych wewnętrznych zasobów silnika OpenEdge RDBMS (będę pisał o licencji Enterprise, która jest przeznaczona do obsługi dużych systemów w porównaniu do wersji Workgroup) wykorzystuje mechanizm niskopoziomowych zapadek (latches). Aby oczekiwanie na zwolnienie zajętej zapadki nie powodowało przestojów, stosuje się mechanizm Spin Locks, który możemy stroić przez parametr startowy -spin.
Pisałem o tym rok temu, ale wciąż spotykam się z pytaniami dotyczącymi ich działania i strojenia.

Jak działają Spin Locks?
Zapadka (latch) to bardzo szybki mechanizm synchronizacji wewnątrz silnika bazy danych. Gdy jeden proces modyfikuje strukturę w pamięci współdzielonej, nakłada na nią zapadkę, aby inne procesy nie naruszyły spójności danych.

Dla zadań o bardzo krótkim czasie trwania stosuje się mechanizm Spin Locks. Zamiast natychmiastowo wstrzymywać proces i usypiać go przy zajętym zasobie, silnik sprawia, że proces “kręci się” w pętli na procesorze (tzw. spinning), wykonując serię szybkich, wielokrotnych prób przejęcia zapadki.

Ponieważ zapadki są zazwyczaj przytrzymywane przez ułamek milisekundy, ponawianie prób bezpośrednio na procesorze pozwala błyskawicznie zdobyć zasób zaraz po jego zwolnieniu.

Konfigurację tego mechanizmu określa parametr startowy -spin (Spin Lock Retries). Parametr ten definiuje, ile maksymalnie razy proces podejmie próbę zdobycia zapadki na zablokowanym zasobie pamięci współdzielonej, zanim przejdzie w stan drzemki.

Cykl obsługi zapadki przebiega następująco:
1. Proces próbuje uzyskać dostęp do zapadki.
2. Jeśli zapadka jest zajęta, proces ponawia próbę w pętli do “N” razy (gdzie N to wartość parametru -spin).
3. Jeśli po wykonaniu ustawionej liczby prób zapadka nadal nie jest wolna, dochodzi do tzw. Latch Timeout (przekroczenia czasu oczekiwania).
4. Proces wstrzymuje działanie (drzemka) na określoną liczbę milisekund.
5. Po wznowieniu pracy proces rozpoczyna cały cykl od nowa i ponawia próby zdobycia zapadki.

Wartość parametru -spin należy dostosować do liczby procesorów (rdzeni) dostępnych w serwerze oraz ich wydajności.
Domyślana wartość jest obliczana jako 6.000 x liczba procesorów zgłoszonych przez system operacyjny. Ponieważ obecna konfiguracja procesorów składa się z rdzeni i działających wątków, wartość ta może być obliczona zbyt wysoko. Jak już pisałem rok temu, w moim laptopie procesor ma 4 rdzenie, 8 wątków a parametr ten ma domyślną wartość 48.000.

Podgląd wartości -spin możemy uzyskać w promonie:
R&D -> 4. Administrative Functions 4. Adjust Latch Options
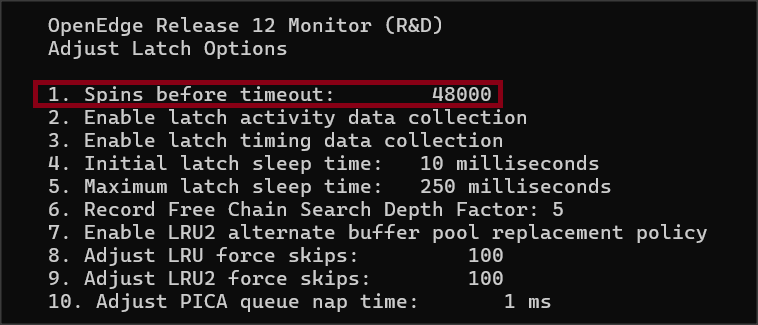

W tym samym miejscu możemy zmienić tę wartość online (podopcja 1).

Eksperci uważają, że w zdecydowanej większości systemów wartości te powinny się zawierać w przedziale 5.000 do 20.000.

Wskazówki diagnostyczne do strojenia:
– Uważajcie na wolne procesory: ustawienie zbyt wysokiej wartości -spin na powolnym sprzęcie może obniżyć ogólną wydajność bazy, ponieważ procesy będą niepotrzebnie marnować cykle CPU na ciągłe próby zdobycia zapadki.

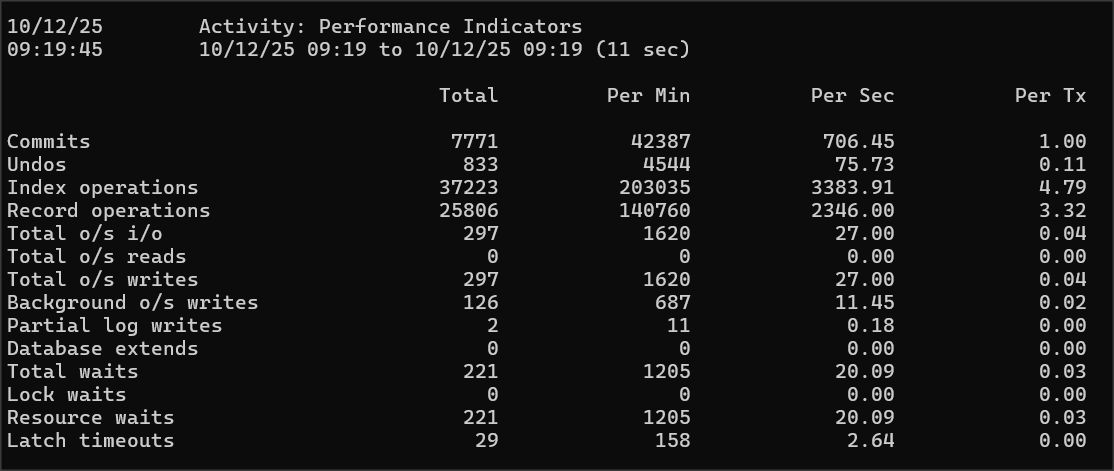
– Monitorujcie Latch Timeouts (najlepiej w promonie):
Im więcej zdarzeń Latch Timeout (przekroczeń czasu oczekiwania) występuje w bazie, tym więcej jest konfliktów i tym niższa wydajność całej aplikacji.
R&D -> 3. Other Displays -> 1. Performance Indicators -> Latch timeouts
Drugim mechanizmem związanym z latches jest łańcuch LRU.
OpenEdge przechowuje w pamięci bufory zawierające bloki bazy danych (ich ilość określana przez parametr -B).
Ponieważ liczba dostępnych buforów jest ograniczona, silnik musi podejmować decyzję, które z nich pozostawić w pamięci, a które mogą zostać zastąpione innymi blokami, ewentualnym zapisaniem na dysk.
Do zarządzania wykorzystaniem buforów wykorzystywany jest między innymi mechanizm LRU (Least Recently Used).

W dużym uproszczeniu możemy wyobrazić sobie poniższy łańcuch:

MRU → [BUF] → [BUF] → [BUF] → [BUF] → [BUF] → [BUF] ← LRU

Bufory używane niedawno znajdują się po stronie MRU (Most Recently Used), natomiast bufory, które dawno nie były używane, przesuwają się w kierunku LRU.

Przy dużej liczbie użytkowników wiele procesów może jednocześnie korzystać z buffer pool. Jeżeli jednocześnie konieczne jest modyfikowanie struktur związanych z LRU, procesy mogą zacząć konkurować o LRU latch. W takiej sytuacji problemem może być nie sam dostęp do danych, ale oczekiwanie na możliwość wykonania operacji związanej z zarządzaniem buforami.

OpenEdge udostępnia mechanizmy pozwalające ograniczyć taką konkurencję.
Administrator ma tu do dyspozycji dwa parametry
-lruskips (do głównej puli buforów -B)
-lruskips2 (do wtórnej puli buforów -B2)

Ustawiając -lruskips = 100 to próba uzyskania latcha LRU będzie co 100-tny dostęp do bufora, co poprawia współbieżność i wydajność. Oczywiście każda taka zmiana jest kompromisem. Jeżeli zbyt mocno ograniczymy aktualizowanie informacji LRU, może to wpłynąć na skuteczność mechanizmu zarządzania buforami.

Obecnie wartości domyślne dla parametru -lruskips i -lruskips2 wynoszą 100 i w zdecydowanej liczbie systemów są one optymalne. Parametry powinny być zmieniane dopiero wtedy, gdy statystyki wskazują na rzeczywisty problem z konkurencją (najczęściej po rekomendacji zespołu wsparcia technicznego).

Wartości obu parametrów można zmienić online w tym samym miejscu co -spin (patrz pierwszy obrazek), opcja 8-9.

W ostatniej części artykułu przyjrzymy się jednemu z najważniejszych obszarów, w których zapadki decydują o wydajności bazy danych przy dużej liczbie użytkowników: strukturze Buffer Hash Table (BHT) oraz jej optymalizacji.

Po pierwsze, czym jest BHT i do czego służy?
Silnik bazy danych OpenEdge przechowuje najczęściej używane bloki danych w pamięci RAM, w tzw. puli buforów (Buffer Pool, parametr -B).

Gdy proces użytkownika chce odczytać lub zmodyfikować konkretny blok z bazy, musi najpierw sprawdzić, czy ten blok znajduje się już w pamięci RAM, czy też trzeba go dopiero pobrać z dysku. Szukanie bloku „po kolei” wśród tysięcy buforów w pamięci byłoby niezwykle niewydajne. Aby natychmiast zlokalizować właściwy bufor, silnik używa struktury BHT (Buffer Hash Table) – specjalnej tablicy mieszającej (hashującej). Proces oblicza wartość hash dla numeru bloku i od razu wie, w którym “kubełku” (bucket) tablicy znajduje się poszukiwany bufor.

Ponieważ setki procesów mogą w tym samym ułamku sekundy przeszukiwać i modyfikować tablicę BHT, dostęp do poszczególnych sekcji tej tablicy musi być chroniony przez zapadki – BHT Latches. Gdy baza danych obsługuje dużą liczbę współbieżnych operacji odczytu i zapisu, może pojawić się zjawisko BHT Latch Contention (rywalizacja o zapadki BHT), co prowadzi do konfliktów i spadku wydajności całej aplikacji.
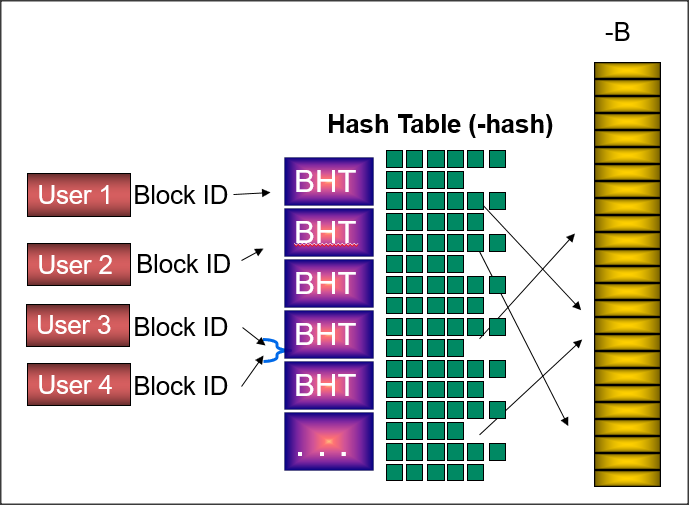
W starszych wersjach systemu OpenEdge liczba zapadek chroniących tablicę BHT była sztywno ograniczona do maksymalnie 1024.

W dobie serwerów wieloprocesorowych i dużych wartości pamięci podręcznej (-B) ten sztywny limit stał się wąskim gardłem. Jedna zapadka musiała chronić zbyt duży fragment tablicy mieszającej, przez co dochodziło do częstych konfliktów. Weżmy np.dość dużą poniższą wartość puli buforów:
-B = 100.000 -> -hash = 25.000 -> ok. 24 elem. BHT/zatrzask

W nowszych wersjach OpenEdge (od 11.7.3+) oraz jako standard w architekturze OpenEdge 12, wprowadzono bardziej elastyczny mechanizm skalowania zapadek BHT za pomocą parametru:
-hashLatchFactor

Parametr ten określa procentowy stosunek liczby zapadek BHT do całkowitej liczby kubełków w tablicy hashującej (-hash). Domyślna wartość wynosi 10%.

Jak to działa w praktyce?
* Parametr -hash definiuje rozmiar tablicy hashującej (liczbe kubełków) – domyślnie jest to 25% wartości -B.
* Parametr -hashLatchFactor definiuje, ile zapadek chroni tę tablicę.
* Zwiększenie wartości -hashLatchFactor powoduje, że pojedyncza zapadka chroni mniejszy fragment struktury BHT.

Dla powyższego przykładu mamy teraz:
-hashLatchFactor domyślnie 10% rozmiaru BHT (-hash)
-B = 100.000 -> -hash = 25.000 -> ok. 10 elem. BHT/zatrzask

Parametr -hashLatchFactor nie może być strojony online. W promonie możemy jedynie podejrzeć jego aktualną wartość.

Na zakończenie warto przypomnieć, że wartości parametrów: -spin, -lruskips, lruskips2, -hashLatchFactor nie mogą być zmieniane na chybił-trafił. Ich strojenie zawsze powinno być poprzedzone analizą statystyk (np. w narzędziu PROMON lub tabelach VST), a często warto zasięgnąć porady w zespole wsparcia technicznego Progressa.
OpenTelemetry w OpenEdge – część II

W poprzednim artykule skonfigurowaliśmy OpenTelemetry w OpenEdge i przygotowaliśmy środowisko, w którym OpenEdge może generować dane telemetryczne.

Tym razem pójdziemy krok dalej. Dane już mamy, teraz zobaczymy jak odebrać je przez wybrany APM.

Do prezentacji trace’ów wybrałem Jaegera, czyli narzędzie opensourcowe przeznaczone do rozproszone tracingu i analizy ścieżki wykonywania operacji w aplikacjach. W naszym przypadku będzie on pełnił rolę środowiska, w którym możemy wyszukiwać i analizować trace’y generowane przez OpenEdge.

Nie jest to oczywiście jedyna możliwość. OpenTelemetry został zaprojektowany tak, aby aplikacja nie była na stałe związana z jednym APM. Jaeger jest jednak bardzo dobrym wyborem do naszego przykładu, ponieważ pozwala szybko zobaczyć strukturę trace’a, poszczególne spany, czasy wykonania oraz zależności pomiędzy nimi.

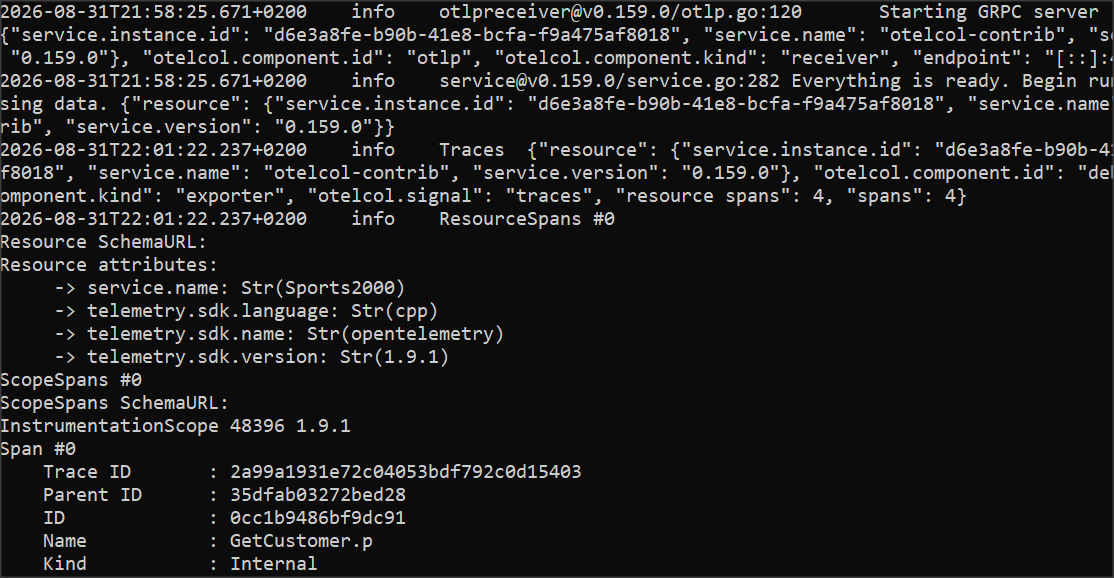
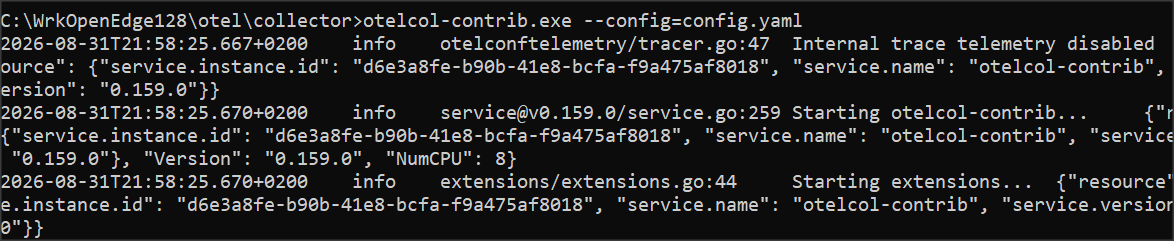
Najpierw przetestujemy wysyłanie danych telemetrycznych do Collectora.
Pobieramy OpenTelemetry Collector ze strony github i rozpakowujemy do własnego katalogu np.:
C:\WrkOpenEdge128\otel\collector

Najprostszy plik konfiguracyjny wygląda następująco: config.yaml

receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

exporters:
  debug:
    verbosity: detailed

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [debug]

otelcol-contrib.exe –config=config.yaml

myOtelConfig2.json

{
    "OpenTelemetryConfiguration": {
        "resource_attributes": "service.name=Sports2000",
        "exporters": {
            "otlp": {
                "grpc": [
                    {
                        "endpoint": "http://localhost:4317",
                        "span_processor": "batch"
                    }
                ]
            }
        }
    },
    "OpenEdgeTelemetryConfiguration": {
        "trace_procedures": "*",
        "trace_classes": "*",
        "trace_abl_transactions": true,
        "trace_requires_parent": false,
        "trace_request_start": true
    }
}

prowin ../db/sports2000 -otelconfig myOtelConfig2.json

Jaeger uruchamiamy z domyślną konfiguracją All-in-One, ale jedną wartość musimy zmienić: endpoint OTLP/gRPC. Spowodowane jest to tym, że do testów wszystkie procesy uruchamiam lokalnie, a Collector już nasłuchuje na 4317, więc Jaeger musi dostać inny port.
Jaeger uruchamiamy poniższym poleceniem:
C:\WrkOpenEdge128\otel\jaeger>jaeger.exe –set=receivers.otlp.protocols.grpc.endpoint=0.0.0.0:14317
Sprawdzamy czy nie ma komuniatów o błędach i pozostawiamy okno otwarte.

Teraz trzeba odpalić sesję klienta openedge żeby Jaeger przechwycił dane z Collectora:
prowin ../db/sports2000 -otelconfig myOtelConfig2.json
Uruchamiam program CustomerOrders.p, co powinno spowodować wyeksportowanie danych telemetrycznych.

Otwieramy interfejs Jaegera w oknie przeglądarki: http://localhost:16686/
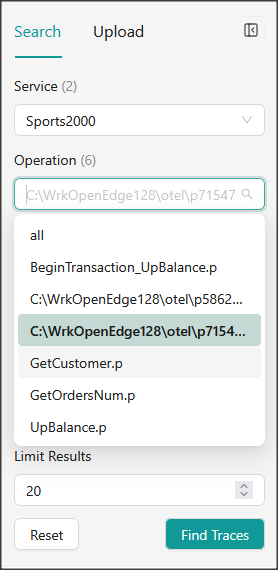
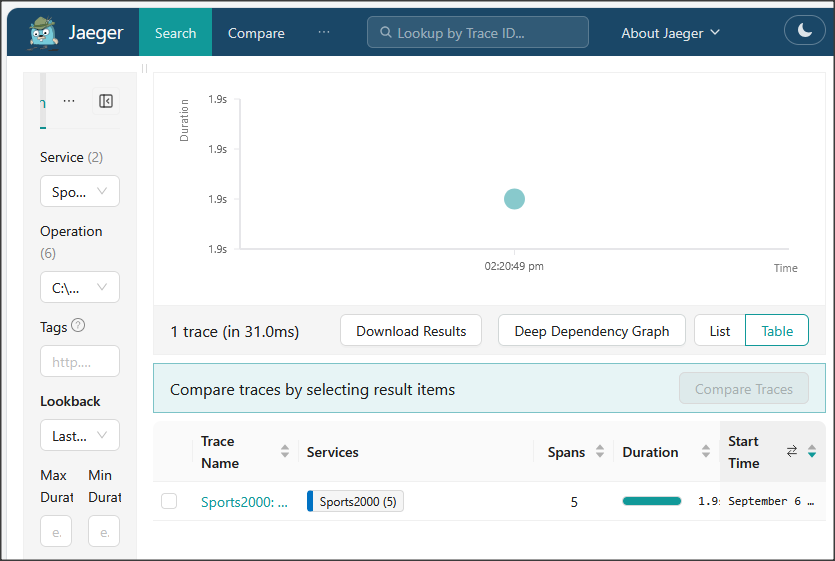
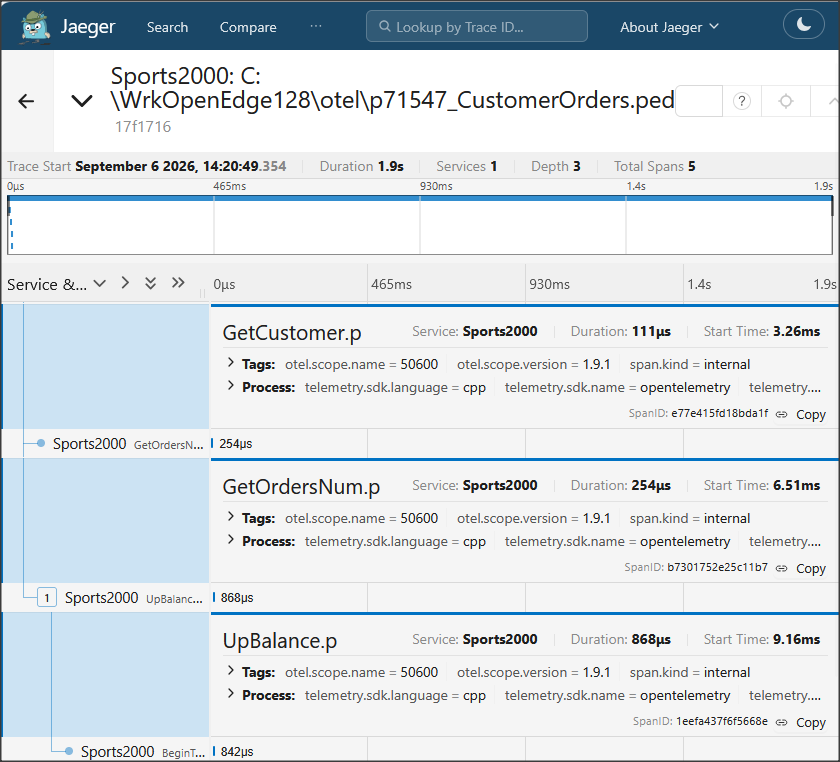
W polu Service wybieramy nazwę naszego serwisu, czyli Sports2000, a następnie nazwę procedury, której metrykę chcemy sprawdzić. Wybieram nazwę z rozszerzeniem .ped, czyli tutaj nadrzędną procedurę CustomerOrders.p.

Widać liczbę spanów: 5. Czas trwania całej procedury, więcej informacji widać na powiększonym ekranie i na dalszych ekranach.

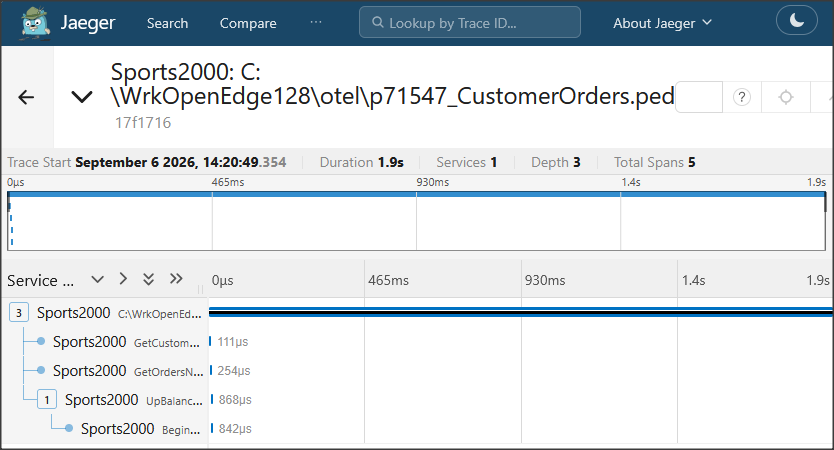
Na przykłąd tu widać całe drzewo wywołań od nadrzędnego id z czasami poszczególnych procedur.

Rozwijając każdy span widać więcej szczegółowych informacji.

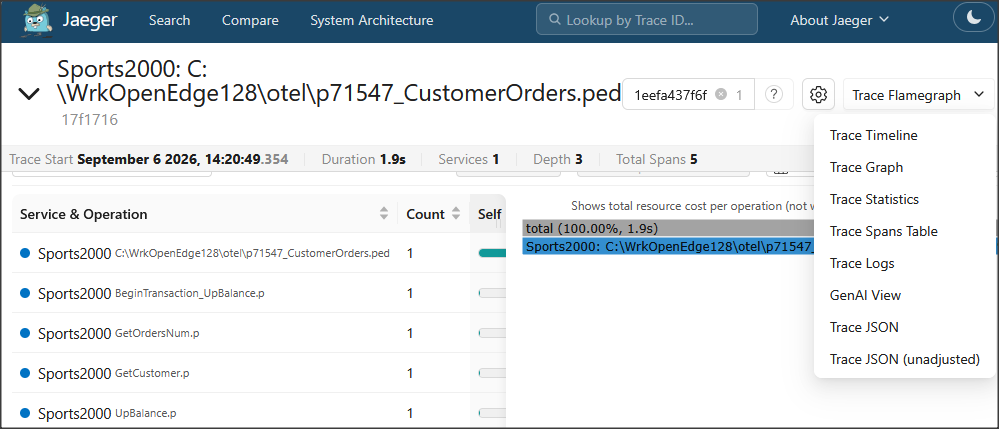
Rozwijając widok Trace Flamegraph (po prawej stronie) przechodzimy do różnego typu widoku: Timeline, Graph, Statistics itd.

OpenTelemetry w OpenEdge – część I

OpenTelemetry pojawiło się w OpenEdge 12.8. Wraz z tą wersją Progress wprowadził tracing zarówno dla ABL Client, jak i PASOE.

Jest to technologia coraz częściej pojawiająca się w środowiskach, w których chcemy wiedzieć nie tylko czy aplikacja działa, ale również co dokładnie robi i gdzie “spędza” najwięcej czasu.

W przypadku aplikacji napisanych w ABL jest to szczególnie interesujące. Przez lata do diagnozowania problemów z aplikacją OpenEdge wykorzystywaliśmy między innymi logi, czy narzędzia diagnostyczne jak Profiler. OpenTelemetry otwiera jednak trochę inną możliwość – możemy spojrzeć na wykonanie aplikacji z perspektywy trace’ów i spanów. I tak, trace opisuje wykonanie całej operacji użytkownika, a spany pokazują poszczególne elementy tego wykonania – np. ABL Client, PASOE, poszczególne procedury itp.

W OpenEdge Progress udostępnia natywne wsparcie dla OpenTelemetry w ABL Client. Nie trzeba więc od razu przebudowywać aplikacji ani dodawać własnego mechanizmu logowania. Tracing można włączyć na poziomie sesji ABL za pomocą parametru -otelconfig. Architektura śledzenia jest dość prosta.

ABL Client → OTLP → OpenTelemetry Collector → APM
ABL Client generuje dane telemetryczne i przekazuje je do OpenTelemetry Collector za pomocą protokołu OTLP. Collector może następnie przekazać je do wybranego narzędzia APM (Application Performance Monitor) np. Elastic APM, Dynatrace czy New Relic.

Na potrzeby pierwszego testu możemy jednak pominąć cały backend APM i instalację Collectora.
W OpenEdge mamy bowiem ostream, który Progress opisuje jako rozwiązanie przydatne właśnie do testowania i debugowania. Zamiast wysyłać trace do Collectora, możemy zapisać je bezpośrednio do pliku.
ABL Client → ostream → plik

Do testowania potrzebna będzie nam aplikacja ABL. Weźmy poniższy przykład składający się z czterech procedur, każda w osobnym pliku. Tylko procedura UpBalance.p generuje transakcję.

// CustomerOrders.p
VAR INTEGER iCustomer = 1, iOrders.
VAR CHARACTER cName.
    
RUN GetCustomer.p (iCustomer, OUTPUT cName).

RUN GetOrdersNum.p (iCustomer, OUTPUT iOrders).

RUN UpBalance.p (iCustomer).

MESSAGE
   cName iOrders
      VIEW-AS ALERT-BOX INFO. 
	  
// GetCustomer.p
DEFINE INPUT PARAMETER piCustNum AS INTEGER NO-UNDO.
DEFINE OUTPUT PARAMETER cName AS CHAR NO-UNDO.

FIND FIRST Customer
    WHERE Customer.CustNum = piCustNum NO-LOCK NO-ERROR.

IF AVAILABLE Customer THEN
    cName = NAME.
ELSE      
    cName = "".

// GetOrdersNum.p
DEFINE INPUT  PARAMETER piCustNum AS INTEGER NO-UNDO.
DEFINE OUTPUT PARAMETER piOrders  AS INTEGER NO-UNDO.
piOrders = 0.

FOR EACH Order WHERE Order.CustNum = piCustNum NO-LOCK:
   piOrders = piOrders + 1.
END.

// UpBalance.p
DEFINE INPUT PARAMETER piCustNum AS INTEGER NO-UNDO.

FIND FIRST Customer
    WHERE Customer.CustNum = piCustNum NO-ERROR.

IF AVAILABLE Customer THEN
    Balance = Balance * 1.1.

Konfiguracja OpenTelemetry jest przechowywana w pliku JSON. Zawiera ona m.in. informacje o exporterze (element OpenTelemetry odpowiedzialny za wysłanie (eksport) zebranych danych telemetrycznych) oraz zakresie śledzenia procedur ABL.

Plik konfiguracyjny przekazujemy do sesji ABL podczas jej uruchamiania za pomocą parametru -otelconfig, wskazując ścieżkę do pliku JSON.
Poniżej widać przykładowy plik konfiguracyjny myOtelConfig.json.

{
    "OpenTelemetryConfiguration": {
        "resource_attributes": "service.name=Sports2000",
        "exporters": {
            "ostream": [
                {
                    "filename": "C:\\WrkOpenEdge128\\otel\\traces.out",
                    "span_processor": "simple"
                }
            ]
        }
    },
    "OpenEdgeTelemetryConfiguration": {
        "trace_procedures": "*",
        "trace_classes": "*",
        "trace_abl_transactions": true,
        "trace_requires_parent": false,
        "trace_request_start": true
    }
}

Uwaga! dla trace_procedures i trace_classes po znaku dziekiej karty * nie może występować żaden ciąg znaków, czyli “Customer*” jest OK, ale “Customer*.p” już jest błędem.
“trace_requires_parent”: false – oznacza: jeżeli nie ma jeszcze nadrzędnego spanu (parent), i tak utwórz span. W przeciwnym razie, dla wartości true oznaczałoby: twórz spany tylko wtedy, gdy istnieje odpowiedni trace/span nadrzędny.

Sesję startuję poleceniem:
prowin ../db/sports2000 -otelconfig myOtelConfig.json
Gdyby pojawiły się błędy lub np. plik wynikowy był pusty, warto dodać parametry generujące log klienta:
prowin ../db/sports2000 -otelconfig myOtelConfig.json -clientlog otel.log -logentrytypes TELEMETRY -logginglevel 3

Plik wynikowy traces.out zawiera informacje o utworzonych spanach. Każdy span posiada między innymi trace_id, który identyfikuje cały ślad wykonania, oraz span_id i parent_span_id, pozwalające określić zależności pomiędzy poszczególnymi operacjami.

Pole name zawiera nazwę śledzonej procedury lub operacji. start określa moment rozpoczęcia spanu, natomiast duration informuje o czasie jego wykonania. W naszym przykładzie wartości czasu podawane są w nanosekundach.

W danych znajdziemy również informacje o rodzaju spanu (span kind), jego statusie oraz atrybutach. W przypadku transakcji OpenEdge możemy zobaczyć dodatkowe informacje, takie jak numer linii czy nazwa bazy danych.

Sekcja resources zawiera informacje opisujące źródło telemetryki. W naszym przypadku jest to między innymi service.name, ustawione w pliku konfiguracyjnym JSON, oraz informacje o wykorzystanej implementacji OpenTelemetry.

Dzięki tym informacjom pojedynczy plik wynikowy zawiera nie tylko listę wykonanych operacji, ale również dane pozwalające odtworzyć ich wzajemne zależności i zmierzyć czas wykonania poszczególnych elementów aplikacji.

W pliku wynikowym znajdziemy również informacje dotyczące transakcji ABL. W naszym przykładzie wykonanie procedury UpBalance.p powoduje utworzenie dodatkowego spanu BeginTransaction_UpBalance.p. Dzięki temu możemy zobaczyć nie tylko czas wykonania samej procedury, ale również czas związany z rozpoczęciem i obsługą transakcji.

Span transakcji może zawierać dodatkowe atrybuty, takie jak numer linii, w której rozpoczęła się transakcja (Line), oraz lista baz danych uczestniczących w operacji (dblist). Pozwala to powiązać dane telemetryczne z konkretnym fragmentem kodu ABL i używaną bazą danych.

Poniżej znajduje się rzeczywisty plik wyniowy traces.out wygenerowany podczas wykonania naszego przykładu. Dodam, że testy przeprowadziłem w środowisku OE 12.8 i 13.0 z podobnym rezultatem.

{
  name          : GetCustomer.p
  trace_id      : b391af61034180280d0c8ac7f847c547
  span_id       : 46814552c7b7f49d
  tracestate    : 
  parent_span_id: dba1567c11e6fce7
  start         : 1787993179723773800
  duration      : 31300
  description   : 
  span kind     : Internal
  status        : Unset
  attributes    : 
  events        : 
  links         : 
  resources     : 
	service.name: Sports2000
	telemetry.sdk.language: cpp
	telemetry.sdk.name: opentelemetry
	telemetry.sdk.version: 1.9.1
  instr-lib     : 54208-1.9.1
}
{
  name          : GetOrdersNum.p
  trace_id      : b391af61034180280d0c8ac7f847c547
  span_id       : d143669da300cb61
  tracestate    : 
  parent_span_id: dba1567c11e6fce7
  start         : 1787993179724423100
  duration      : 74600
  description   : 
  span kind     : Internal
  status        : Unset
  attributes    : 
  events        : 
  links         : 
  resources     : 
	service.name: Sports2000
	telemetry.sdk.language: cpp
	telemetry.sdk.name: opentelemetry
	telemetry.sdk.version: 1.9.1
  instr-lib     : 54208-1.9.1
}
{
  name          : BeginTransaction_UpBalance.p
  trace_id      : b391af61034180280d0c8ac7f847c547
  span_id       : 47fbd8c581af2e2c
  tracestate    : 
  parent_span_id: f2489adf6e462ba0
  start         : 1787993179724894000
  duration      : 887200
  description   : 
  span kind     : Internal
  status        : Unset
  attributes    : 
	Line: 1
	dblist: sports2000
  events        : 
  links         : 
  resources     : 
	service.name: Sports2000
	telemetry.sdk.language: cpp
	telemetry.sdk.name: opentelemetry
	telemetry.sdk.version: 1.9.1
  instr-lib     : 54208-1.9.1
}
{
  name          : UpBalance.p
  trace_id      : b391af61034180280d0c8ac7f847c547
  span_id       : f2489adf6e462ba0
  tracestate    : 
  parent_span_id: dba1567c11e6fce7
  start         : 1787993179724885700
  duration      : 930800
  description   : 
  span kind     : Internal
  status        : Unset
  attributes    : 
  events        : 
  links         : 
  resources     : 
	service.name: Sports2000
	telemetry.sdk.language: cpp
	telemetry.sdk.name: opentelemetry
	telemetry.sdk.version: 1.9.1
  instr-lib     : 54208-1.9.1
}
{
  name          : C:\WrkOpenEdge128\otel\p78729_CustomerOrders.ped
  trace_id      : b391af61034180280d0c8ac7f847c547
  span_id       : dba1567c11e6fce7
  tracestate    : 
  parent_span_id: 0000000000000000
  start         : 1787993179722973700
  duration      : 3154827200
  description   : 
  span kind     : Internal
  status        : Unset
  attributes    : 
  events        : 
  links         : 
  resources     : 
	service.name: Sports2000
	telemetry.sdk.language: cpp
	telemetry.sdk.name: opentelemetry
	telemetry.sdk.version: 1.9.1
  instr-lib     : 54208-1.9.1
}

W powyższym pliku widać, że wszystkie spany należące do jednego wykonania aplikacji mają ten sam trace_id (b391af61034180280d0c8ac7f847c547). Jest to identyfikator całego śladu (trace), dzięki któremu można powiązać ze sobą poszczególne operacje składające się na jedno wykonanie programu. W naszym przykładzie pozwala on powiązać CustomerOrders.ped z wywołanymi przez nią procedurami GetCustomer.p, GetOrdersNum.p oraz UpBalance.p.

W następnym odcinku, napiszę jak włączyć w ten proces Otel Collector.

FIPS 140-3 w OpenEdge 13 – cześć II

W poprzedniej części artykułu skonfigurowaliśmy środowisko OpenEdge 13 do pracy w trybie FIPS 140-3. Pokazaliśmy jak zarejestrować katalog DLC w ESAM oraz jak właczyć/wyłaczyć i sprawdzić status FIPS za pomocą narzędzia POLMAN.

Samo włączenie FIPS jest jednak dopiero początkiem. Z punktu widzenia administratora najważniejsze pytanie brzmi:
co stanie się z działającą bazą danych i serwerem PASOE po włączeniu FIPS?
W tej części skupimy się właśnie na tych dwóch elementach środowiska.

OpenEdge RDBMS jest jednym z kluczowych komponentów OpenEdge obsługujących tryb FIPS. Dokumentacja Progress wymienia w tym kontekście między innymi Transparent Data Encryption (TDE), HSM oraz Auditing.
Nie oznacza to jednak, że każda istniejąca baza wymaga pewnej konwersji.
Przejście na FIPS należy traktować przede wszystkim jako zmianę zasad dotyczących używanych mechanizmów kryptograficznych.
Baza może nadal zawierać dane utworzone przed aktywacją FIPS, jednak elementy wykorzystujące starsze, niezatwierdzone mechanizmy kryptograficzne mogą wymagać aktualizacji. O tych przestarzałych algorytmach wspomniałem w poprzednim artykule dotyczącym Transparent Data Encryption. Baza danych musi być zatrzymana i wystartowana ponownie po włączeniu FIPS.

Rozpocznijmy od sprawdzenia statusu i włączenia trybu FIPS.

Posłużę się teraz bazą mytde, którą utworzyłem w poprzednim artykule. Baza ma włączone szyfrowanie TDE. Można to sprawdzić na różne sposoby, np. komendą proutil describe.

Startujemy serwer bazy z podaniem hasła -Passphrase. Od razu widać informację odnośnie trybu FIPS.

Po ponownym uruchomieniu bazy warto sprawdzić:
– log bazy danych .lg
– możliwość połączenia aplikacji
– możliwość zalogowania użytkowników (ABL, SQL)
– działanie mechanizmów TDE/HSM (jeśli są zaimplementowane)
– ewentualne błędy dotyczące algorytmów kryptograficznych.

Przy migracji istniejącej bazy do OpenEdge 13 należy zwrócić szczególną uwagę na hasła użytkowników. Jest to istotne zwłaszcza wtedy, gdy baza pochodzi z OpenEdge 12.8 lub wcześniejszej wersji.
OpenEdge 13 wprowadza bezpieczniejszy mechanizm generowania hashy haseł. Nowo tworzone hasła są generowane przy użyciu funkcji GENERATE-PASSWORD-HASH, która obsługuje algorytmy zatwierdzone przez National Institute of Standards and Technology (NIST). Starsze hasła mogły natomiast zostać zapisane przy użyciu funkcji ENCODE().
Progress udostępnił w OpenEdge 13 prosty sposób na sprawdzenie, którzy użytkownicy posiadają jeszcze hasła utworzone przy użyciu starszego mechanizmu.

W Data Administration Tool należy wybrać:
Admin → Security → User Report

Wygenerowany raport zawiera między innymi kolumnę: New Pwd?
Yes – hasło zostało wygenerowane za pomocą GENERATE-PASSWORD-HASH;
No – hasło zostało zakodowane za pomocą starszej funkcji ENCODE().

Przykładowo raport może wyglądać następująco:

User ID       User Name             Pwd?    SQL only    New Pwd?
-----------------------------------------------------------------
admin         Administrator         yes     no          yes
user1         Jan Kowalski          yes     no          no
user2         Anna Nowak            yes     yes         yes

W takim przypadku użytkownik user1 wymaga szczególnej uwagi przed włączeniem FIPS, ponieważ jego hasło zostało zapisane przy użyciu starszego mechanizmu ENCODE(). MOżna to łatwo naprawić ustawiając nowe hasło,

Po włączeniu FIPS zaleca się również sprawdzenie logów agenta PASOE.
Jest to szczególnie istotne dlatego, że część problemów nie musi pojawić się podczas samego uruchamiania bazy. Mogą zostać ujawnione dopiero wtedy, gdy aplikacja wykona operację wymagającą konkretnego algorytmu kryptograficznego.

Drugim kluczowym elementem środowiska OpenEdge jest PASOE. Przed włączeniem trybu FIPS należy zatrzymać a następnie wyrejestrować wszystkie działające instancje poleceniem:
pasman unregister nazwa-instancji.
Po włączeniu FIPS i zrestartowaniu baz danych rejestrujemy ponownie instancje poleceniem:
pasman register nazwa-instancji ścieżka.
Po zarejestrowaniu instancji PASOE w środowisku FIPS należy zwrócić uwagę na jeszcze jeden element konfiguracji. Dokumentacja jasno wskazuje, że aby identyfikatory sesji generowane podczas Basic Authentication korzystały z algorytmów zatwierdzonych przez FIPS, należy odkomentować sekcję Valve w pliku: webapps//META-INF/context.xml
np. C:\WrkOpenEdge130\oepas1\webapps\ROOT\META-INF\context.xml.

Kolejnym krokiem jest ponowne wygenerowanie istniejących domain keystores (magazynów kluczy domeny) PASOE za pomocą narzędzia gendomreg. Progress wskazuje, że należy wykonać tę operację, aby istniejące keystore’y korzystały z modułów kryptograficznych pracujących w trybie FIPS.
Jest to szczególnie istotne w przypadku istniejących instancji PASOE, których domain keystore został utworzony przed włączeniem FIPS. Nie należy zakładać, że sama zmiana globalnej polityki ESAM automatycznie przygotuje istniejący keystore do pracy w trybie FIPS.
Ostatnim krokiem jest restart instancji PASOE i sprawdzenie logów czy nie ma w nich błędów.

TDE w bazach OpenEdge

Ostatni artykuł dotyczył podstawowych informacji związanych z zastosowania FIPS w OpenEdge. Zanim napiszę trochę więcej na ten temat, postanowiłem skupić się na innym rozwiązaniu – Transparent Data Encryption (TDE). Po pierwsze, kilku z Was prosiło mnie o to już wcześniej, a po drugie, ta wiedza przyda się przy włączaniu FIPS w bazach danych.

Bezpieczeństwo danych od wielu lat pozostaje jednym z najważniejszych wyzwań dla organizacji rozwijających systemy biznesowe. Rosnące wymagania regulacyjne m.in. RODO (GDPR), PCI DSS czy HIPAA, coraz bardziej zaawansowane cyberataki oraz potrzeba ochrony danych przed nieautoryzowanym dostępem sprawiają, że szyfrowanie danych „w spoczynku” (data at rest) stało się standardem, a nie opcjonalnym dodatkiem.

W środowiskiem Progress OpenEdge odpowiedzią na te potrzeby jest Transparent Data Encryption (TDE). Choć funkcjonalność ta została wprowadzona już kilka lat temu, wciąż pozostaje jednym z najważniejszych elementów strategii bezpieczeństwa platformy. Co więcej, kolejne wersje OpenEdge przynoszą jej dalszy rozwój – od silniejszych mechanizmów kryptograficznych, przez usprawnione zarządzanie kluczami, aż po lepsze wsparcie dla współczesnych wymagań związanych z bezpieczeństwem i zgodnością z przepisami.

Czym jest Transparent Data Encryption?

Transparent Data Encryption (TDE) to mechanizm szyfrujący dane przechowywane w bazie danych w sposób całkowicie transparentny dla aplikacji. Oznacza to, że aplikacja korzystająca z bazy OpenEdge nie wymaga żadnych zmian w kodzie – dane są automatycznie szyfrowane podczas zapisu na dysk oraz odszyfrowywane podczas odczytu.

Najważniejszym celem TDE jest ochrona danych przechowywanych na nośnikach fizycznych. Nawet jeśli ktoś uzyska dostęp do plików bazy danych, kopii zapasowej lub binarnych zrzutów danych, ich zawartość pozostanie bezużyteczna bez odpowiednich kluczy szyfrujących. Mechanizm ten nie zastępuje kontroli dostępu ani uwierzytelniania użytkowników – stanowi dodatkową warstwę ochrony, zabezpieczając dane przed ich fizycznym przejęciem.

Jedną z największych zalet OpenEdge TDE jest to, że szyfrowanie zostało zaimplementowane bezpośrednio w silniku bazy danych. Administrator definiuje politykę szyfrowania oraz zarządza kluczami, natomiast aplikacja nadal działa tak samo jak wcześniej. Dzięki temu wdrożenie TDE jest znacznie prostsze niż implementowanie własnych mechanizmów kryptograficznych na poziomie kodu aplikacji.

W praktyce OpenEdge TDE chroni dane zapisane w tabelach, indeksach, obszarach bazy danych, plikach AI i BI oraz kopiach zapasowych i binarnych dumpach. Mechanizm wykorzystuje standardowe algorytmy kryptograficzne oraz oddzielny magazyn kluczy (Key Store), w którym przechowywany jest główny klucz bazy danych (Database Master Key). Na jego podstawie generowane są unikalne klucze dla poszczególnych zaszyfrowanych obiektów, co znacząco zwiększa poziom bezpieczeństwa całego rozwiązania.

Co może być zaszyfrowane:
– Obszary typu I (Type I Storage Areas) – szyfrowany jest cały obszar typu I.
– Tabele, indeksy oraz obiekty LOB w obszarach typu II (Type II Storage Areas).
– Pliki Before Image (BI) – są szyfrowane domyślnie.
– Pliki After Image (AI) – są szyfrowane domyślnie.
– Kopie zapasowe tworzone za pomocą narzędzia probkup – są zawsze szyfrowane.
– Pliki Binary Dump – domyślnie nie są szyfrowane.

Pierwszym krokiem podczas wdrażania Transparent Data Encryption jest utworzenie w bazie danych dedykowanego obszaru p nazwie: “Encryption Policy Area”, który będzie przechowywał informacje o zdefiniowanych politykach szyfrowania.

Obszar ten nie będzie zawierać zaszyfrowanych danych ani kluczy szyfrujących. Jego zadaniem jest przechowywanie metadanych opisujących, które obiekty bazy danych mają przypisaną politykę szyfrowania. Dla każdego obiektu, takiego jak obszar bazy danych, tabela, indeks czy LOB, tworzony jest jeden rekord zawierający informacje o przypisanej polityce.
Ze względu na to, że przechowywane są wyłącznie metadane, rozmiar obszaru jest bardzo niewielki. Nawet w dużych bazach danych zwykle nie przekracza on kilku megabajtów.

Warto pamiętać, że Encryption Policy Area musi zostać utworzony jako obszar składowania typu II (ze specjalnym tokenem “e” w pliku struktury). Jest to wymaganie mechanizmu TDE i bez spełnienia tego warunku nie będzie możliwe definiowanie polityk szyfrowania dla obiektów bazy danych.

Utworzymy więc plik add.st i dodamy do bazy mytde (kopia sports2000) obszar “Encryption Policy Area” a także własny obszar “NewCust” typu II (z clustrem 8) żeby pokazać jak można szyfrować dane dla poszczególnych obiektów.

# add.st
d "NewCust":13,32;8 . f 320
d "NewCust":13,32;8 .
#
e "Encryption Policy Area":80,32;8 .

Dodajemy obszary poleceniem: prostrct add mytde add.st

(UWAGA! komendy związane z zabezpieczeniami uruchamiamy jako jako Administrator systemu.)

Kolejnym krokiem jest włączenie obsługi szyfrowania w bazie danych. W tym celu należy wykonać polecenie:
proutil mytde -C enableencryption
Podczas wykonywania polecenia system poprosi o dwukrotne podanie hasła (passphrase), które będzie wykorzystywane do zabezpieczenia kluczy szyfrujących bazy danych.

Teraz przenoszę tablice customer i order do obszaru NewCust – muszę podać zdefiniowane wcześniej passphrase.

Baza jest zatem gotowa do szyfrowania. Włączam szyfrowanie dla tabeli customer:
proutil mytde -C epolicy manage table encrypt Customer -Passphrase

Jeszcze jedna uwaga. Po włączeniu Transparent Data Encryption baza danych domyślnie działa w trybie manual. Oznacza to, że podczas wykonywania operacji administracyjnych należy użyć parametru -Passphrase, a następnie podać hasło zdefiniowane podczas wykonywania polecenia proutil db -C enableencryption. Jest to dodatkowy mechanizm zabezpieczający, który uniemożliwia wykonywanie operacji na zaszyfrowanej bazie bez wcześniejszego uwierzytelnienia. Bazę można skonfigurować także w trybie auto, ale o tym nie będę tu pisał.
Możemy sprawdzić teraz czy szyfrowanie rzeczywiście jest włączone. Pierwsze polecenie (epolicy view) informuje, że jest.

Drugie polecenie (epolicy scan) informuje dodatkowo, że zaszyfrowane jest 7 z 48 bloków bazy.
Pozostałe będą szyfrowane na bieżąco, chyba że chcemy zasyfrować od razu całą tabelę.
Możemy to zrobić wykonując polecenie:
proutil mytde -C epolicy manage table update Customer -Passphrase

Jeśli powtórzę komendę skanowania, to widać że wszystkie bloki tabeli sa już zaszyfrowane.
Warto dodać, że skanowanie i podgląd szyfrowania (scan area, view area) można uruchomić także dla obszaru, ale wyłącznie jeśli to jest obszar typu I. Dla obszaru typu II pojawi się błąd.

Jeśli nie podajemy numeru szyfru to zostanie użyty szyfr 1. Wszystkie dostępne mamy w poniższym zestawieniu:

  • 0 – NULL (brak szyfrowania)
  • 1 – AES_CBC_128 (domyślny)
  • 2 – AES_CBC_192
  • 3 – AES_CBC_256
  • 4 – DES_CBC_56
  • 5 – DES3_CBC_168

Dwa ostatnie szyfry są słabe. Spróbujmy zaszyfrować tabelę Order szyfrem DES_CBC_56.
proutil mytde -C epolicy manage table encrypt Order -Cipher 4 -Passphrase

Chociaż dokumentacja nadal wymienia algorytmy DES_CBC_56 i DES3_CBC_168 jako obsługiwane, OpenEdge 13 traktuje je jako algorytmy przestarzałe (deprecated). Mogą występować w starszych bazach danych, jednak nie można ich użyć do tworzenia nowych polityk szyfrowania. Progress zaleca stosowanie wyłącznie algorytmów z rodziny AES.

Do zarządzania szyfrowaniem tabel można użyć także komend SQL lub narzędzia Data Administration. W tym ostatnim wchodzimy w Admin -> Security -> Encryption Policies -> Edit Encryption Policy. Wybieramy tabelę i OK.

To na razie tyle. Dość spory materiał do przetestowania, a i to nie jest oczywiście wszystko. Powodzenia!

FIPS 140-3 w OpenEdge 13

Wraz z premierą Progress OpenEdge 13, twórcy oprogramowania i administratorzy systemów otrzymali potężne narzędzie do walki o cyberbezpieczeństwo. Wersja ta wprowadza pierwsze produkcyjne wdrożenie standardu kryptograficznego FIPS 140-3 dla kluczowych komponentów systemu. FIPS 140-3 jest najnowszym standardem rządu USA, który definiuje wymagania bezpieczeństwa dla modułów kryptograficznych. W OpenEdge 13 aktywacja FIPS mode sprawia, że środowisko wykonawcze (AVM), bazy danych RDBMS oraz serwery aplikacyjne PASOE wymuszają stosowanie wyłącznie zwalidowanych przez NIST* bibliotek oraz silnych algorytmów do szyfrowania i zarządzania kluczami.

Jeśli pracujesz w branży finansowej, medycznej lub rządowej, wdrożenie trybu FIPS (Federal Information Processing Standards) staje się fundamentem zgodności regulacyjnej. Jak zatem podejść do tego tematu jako administrator?

Po pierwsze, do uruchomienia trybu FIPS wymagany jest pakiet licencyjny Progress OpenEdge Advanced Security (OEAS). Upewnijmy się, że posiadamy go w instalacji.
Poza tym, przeprowadzając audyt certyfikatów SSL/TLS pod kątem zgodności z FIPS, musimy pamiętać, że tryb ten bezwzględnie odrzuci słabą kryptografię. Wszystkie asymetryczne klucze certyfikatów oparte na algorytmie RSA, używane w komunikacji sieciowej lub do ochrony kluczy szyfrujących bazy danych (TDE), muszą mieć długość minimum 2048 bitów. W przypadku stosowania nowoczesnych certyfikatów z użyciem krzywych eliptycznych (ECC/ECDSA) wymagana jest długość klucza wynosząca minimum 256 bitów.


Tryb
FIPS włączamy w środowisku OpenEdge za pomocą narzędzia ESAM/POLMAN.
Przypomnijmy, że ESAM (Embedded Security Architecture Module) to wewnętrzny system bezpieczeństwa wprowadzony w OpenEdge 12.6. Monitoruje procesy Progressa i blokuje uruchamianie plików z nieautoryzowanych ścieżek. Stanowi fundament pod bezpieczną architekturę i wymuszanie trybu FIPS.
POLMAN (Policy Manager) to narzędzie wiersza poleceń do zarządzania systemem ESAM. Służy do tworzenia, edycji i podpisywania polityk bezpieczeństwa platformy. Za jego pomocą administratorzy aktywują i konfigurują zgodność środowiska z normami FIPS.

Warto więc na poczatku sprawdzić czy ESAM jest poprawnie zainstalowany. Ponieważ miałem wcześniej zainstalowane w Windows niższe wersje OE od 12.6 do 12.8, to po ich wyinstalowaniu pozostały katalogi/pliki ESAM:
C:\Windows\System32\openedge.d
C:\Windows\System32\openedge

Skorzystałem z rozwiązania z bazy wiedzy (nr 000297865) żeby je usunąć jako administrator. Uwaga! możemy tak zrobić tylko jeśli nie mamy już zainstalowanych tych wersji. Ta operacja nie jest niezbędna ale warto wyczyścić struktrurę ESAM jeśli odnosi się do wyinstalowanych już wersji.

Po zainstalowaniu OE 13, sprawdziłem w logach, że ESAM został poprawnie zainstalowany jednak uruchamiając komendę C:\Windows\System32\openedge.d\bin>valdlc -dlc C:\OpenEdge130 okazało się, że walidacja katalogu DLC kończy się niepowodzeniem. To dość częsty przypadek. Możemy jednak zarejestrować ten katalog ręcznie poleceniem:
C:\Windows\System32\openedge.d\sbin>setdlc.bat -esamregisterDLC C:\OpenEdge130

Sprawdzamy jeszcze raz walidację:
C:\Windows\System32\openedge.d\bin>valdlc -dlc C:\OpenEdge130

Aby aktywować FIPS trzeba uruchomić terminal OpenEdge proenv z uprawnieniami administratora.
Najpierw warto wyświetlić aktualny status polityki globalnej ESAM oraz sprawdzić, czy tryb FIPS jest już aktywny, wpisujemy polecenie:
proenv>polman get -policy urn:esam:fips140:can-run-without
Walidacja kończy się teraz sukcesem.

Tryb FIPS włącza się komendą:
polman set -policy urn:esam:fips140:can-run-without -value no

Po wprowadzeniu zmiany, ponownie zweryfikuj stan polityki w ESAM, aby upewnić się, że flaga została poprawnie zapisana:
proenv>polman get -policy urn:esam:fips140:can-run-without
Wyłączamy FIPS poleceniem:
polman set -policy urn:esam:fips140:can-run-without -value yes
i ponownie testujemy.
Obie komendy przedstawione są poniżej.

Wdrożenie trybu FIPS po stronie infrastruktury to właściwie mniej niż połowa sukcesu. Administrator musi ściśle współpracować z programistami, ponieważ FIPS blokuje starsze funkcje w kodzie ABL.
Na przykłąd użycie funkcji ENCODE() zakończy się błędem ponieważ tradycyjna metoda tworzenia skrótów haseł nie spełnia wymogów standardu. Deweloperzy muszą zastąpić ją nowszą funkcją GENERATE-PASSWORD-HASH. Podobnie funkcja MD5-DIGEST() czy SHA1-DIGEST().
Przed włączeniem FIPS warto dokładnie zapoznać się z dokumentacją i sprawdzić kod źródłowy – część problemów pojawia się dopiero podczas runtime’u, a nie podczas kompilacji.
Testowanie warunkowe: Programiści mogą zabezpieczyć kod przed błędami kryptograficznymi, sprawdzając stan środowiska za pomocą systemowego atrybutu: SECURITY-POLICY:FIPS-MODE.
Poniżej mamy prosty kod do wykrywania trybu FIPS.

//test_fips.p
IF SECURITY-POLICY:FIPS-MODE THEN DO:
	MESSAGE "Success: FIPS 140-3 is on!" 
    	VIEW-AS ALERT-BOX INFORMATION.
END.
ELSE DO:
	MESSAGE "Warning: FIPS is not working!" 
    	VIEW-AS ALERT-BOX WARNING.
END.


Wdrożenie FIPS 140-3 w Progress OpenEdge 13 to kamień milowy w zabezpieczaniu danych przedsiębiorstwa. Choć wymaga przygotowania infrastruktury i audytu kodu, to widzimy, że centralne wymuszenie restrykcyjnych reguł bezpieczeństwa jest dość proste.

Na koniec jeszcze jedna ważna kwestia – pamiętajmy o tym, że OpenEdge nie działa w próżni. Jeśli włączymy FIPS w OpenEdge, ale nasz system operacyjny (Windows Server lub Linux) będzie skonfigurowany niezgodnie z tym standardem, środowisko nie osiągnie pełnej zgodności.

Poniżej podaję przykładową instrukcję konfiguracji systemu operacyjnego.
Windows Server – w menu komend uruchom gpedit.msc aby otworzyć Edytor lokalnych zasad grupy.
W lewym panelu przejdź kolejno do ścieżki: Konfiguracja komputera -> Ustawienia systemu Windows -> Ustawienia zabezpieczeń -> Zasady lokalne -> Opcje zabezpieczeń.
W prawym panelu znajdź i kliknij dwukrotnie zasadę: Kryptografia systemu: Użyj zgodnych algorytmów FIPS do szyfrowania, haszowania i podpisywania. Zmień ustawienie na Włączone, kliknij Zastosuj, a następnie OK.
Otwórz wiersz poleceń (cmd) jako administrator i wymuś aktualizację zasad komendą: gpupdate /force

Linux – zaloguj się na serwer jako użytkownik z uprawnieniami root lub użyj sudo. Sprawdź obecny status za pomocą polecenia: fips-mode-setup –check
Jeśli tryb FIPS jest wyłączony, aktywuj go systemowo wpisując: fips-mode-setup –enable
Uruchom ponownie serwer (komendą reboot), aby system operacyjny przełączył jądro (kernel) oraz systemowe biblioteki w restrykcyjny tryb FIPS 140-3. Po restarcie upewnij się, że system działa poprawnie, powtarzając pierwszą komendę: fips-mode-setup –check.

Powyższe informacje na temat konfiguracji systemu operacyjnego przedstawiłem opcjonlanie. Przykładowe włączenie FIPS w OpenEdge 13 przeprowadziłem bez zmian systemowych.
Ciąg dalszy nastąpi.

* NIST to skrót od National Institute of Standards and Technology (Narodowy Instytut Standardów i Technologii).Jest to amerykańska agencja rządowa, która podlega pod Departament Handlu USA. To właśnie NIST tworzy i publikuje standardy z serii FIPS (w tym opisywany FIPS 140-3). Definiują one, jakie algorytmy kryptograficzne i moduły bezpieczeństwa są bezpieczne i dopuszczone do użytku w instytucjach rządowych oraz branżach regulowanych.

DDM – rozszerzenie tematu

O technologii Dynamic Data Masking pisałem dwukrotnie w 2025 roku, aby przybliżyć jej działanie użytkownikom baz danych Progress OpenEdge od wersji 12.8. W poprzednich artykułach skupiłem się głównie na podstawach: omówiłem sposób aktywacji mechanizmu DDM w bazie danych oraz konfigurację czterech dostępnych typów masek dla wybranych pól i tabel.

Dynamic Data Masking jest jednak rozwiązaniem, które poza samą konfiguracją wymaga również dobrego zrozumienia sposobu działania mechanizmu maskowania, jego wpływu na aplikacje oraz pewnych ograniczeń. W praktyce oznacza to, że wdrożenie DDM nie sprowadza się wyłącznie do zdefiniowania reguł maskowania, ale powinno być poprzedzone analizą wymagań bezpieczeństwa, zgodności oraz wpływu na istniejące reguły biznesowe.

W tym artykule chciałbym więc spojrzeć na tę technologię z bardziej praktycznej i technicznej perspektywy. Pokażę nie tylko zalety wynikające z zastosowania Dynamic Data Masking, ale również ograniczenia i potencjalne problemy, które mogą pojawić się podczas wdrożenia. Odniosę się także do kilku nieporozumień dotyczących działania DDM, które pojawiały się w pytaniach i dyskusjach po publikacji wcześniejszych materiałów.

Jednym z pytań było: co się stanie jeśli pole typu INTEGER będzie przesłane do obiektu, jako wartość wymagana, a administrator nałoży na nie maskę PARTIAL. Otóż należy pamiętać, że dla każdego rodzaju maski obowiązuje zasada zgodności typów. Spróbujmy zastosować taką maskę na pole Balance (DECIMAL). Postępujemy dokładnie tak jak w poprzednich artykułach, a na koniec nakładamy maskę:

USING OpenEdge.DataAdmin.DataAdminService FROM PROPATH.

DEFINE VARIABLE service AS DataAdminService NO-UNDO. 
DEFINE VARIABLE lResult AS LOGICAL NO-UNDO.

service = NEW DataAdminService(LDBNAME("DICTDB")).
lResult = service:setDDMConfig("Customer","Balance","P:2,*","#DDM_SEE_ContactInfo").

Dostajemy komunikat o błędzie wynikający z konfliktu pola liczbowego z maską znakową.


Przejdę teraz do ważniejszej kwestii związanej z DDM, ale najpierw zdefiniuję maskę domyślną dla pola Balance.

USING OpenEdge.DataAdmin.DataAdminService FROM PROPATH.

DEFINE VARIABLE service AS DataAdminService NO-UNDO. 
DEFINE VARIABLE lResult AS LOGICAL NO-UNDO.

service = NEW DataAdminService(LDBNAME("DICTDB")).
lResult = service:setDDMConfig("Customer","Balance","D:","#DDM_SEE_ContactInfo").

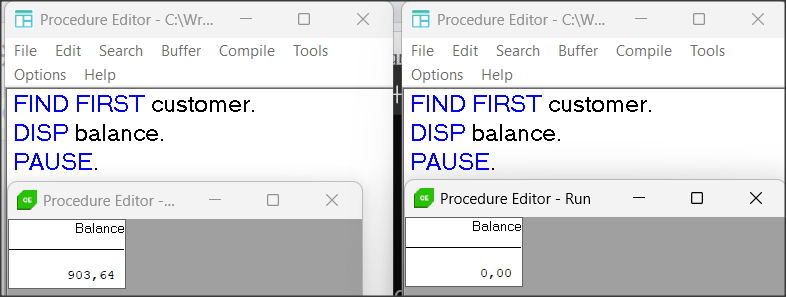
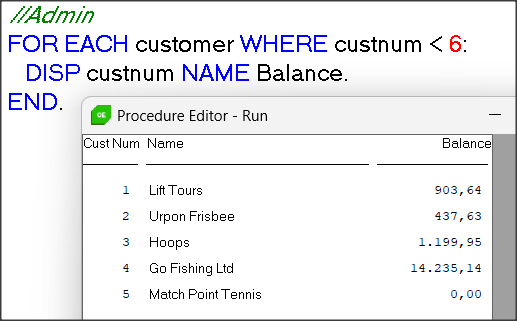
Startuję dwie sesje w edytorze procedur, logując się do bazy jako Admin i jako User. Uruchamiam prosty program wyświetlający wartość pola Balance dla pierwszego rekordu Customer. Zgodnie z przewidywaniem dla Admina jest to prawdziwa wartość (z lewej), a dla Usera wartość zamaskowana, czyli zero (z prawej).

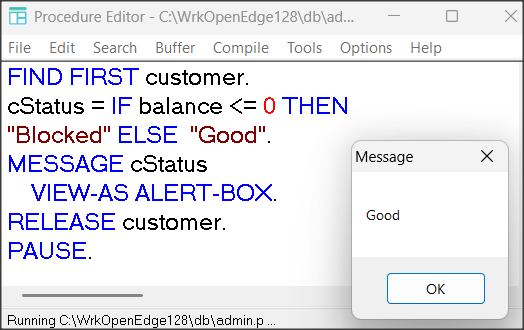
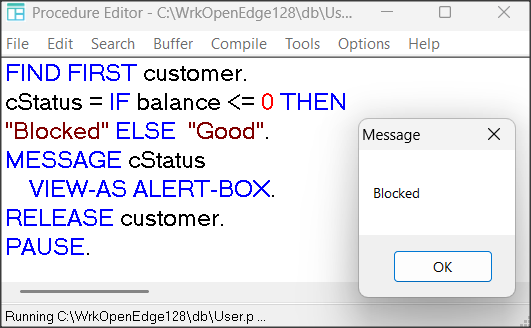
Podstawowe pytanie brzmi: na jakim poziomie odbywa się maskowanie danych? Czy na warstwie prezentacji czy dostępu do danych? Jest to kwestia zasadnicza, ale zanim to wyjaśnimy uruchomię jeszcze jeden prosty przykład. Dodałem do tablicy Customer pole znakowe cStatus. W zależności od wartości pola Balance ustawiany jest status klienta. Jeśli jego Balance, czyli “saldo” wynosi zero to status zmienia się na “Blocked”.
Pole Balance nie jest tutaj wyświetlane. Uruchamiam program ponownie jako Admin…

… i jako User.

Widzimy, że chociaż wartość pola Balance jest niezerowa, to logika aplikacji w drugim oknie widzi ją jako właśnie zerową. Ten przykład pokazuje najważniejszy problem związany z Dynamic Data Masking — mechanizm maskowania może wpływać nie tylko na prezentację danych, ale również na działanie logiki biznesowej. Zresztą, nie ma co się dziwić. Gdyby maskowanie dotyczyło tylko wyświetlania danych wystarczyłoby przypisać pole do zmiennej i je wyświetlić.

A zatem w wielu przypadkach aplikacja otrzymuje już zamaskowaną wartość podczas odczytu danych z bazy. Oznacza to, że warunki biznesowe, walidacje czy obliczenia mogą działać na danych zmodyfikowanych przez mechanizm DDM. Dlatego maskowanie danych nie powinno być traktowane jako element logiki aplikacyjnej.

Najbezpieczniejszym podejściem jest rozdzielenie warstw odpowiedzialności:
– logika biznesowa powinna operować na rzeczywistych danych,
– maskowanie powinno być stosowane na etapie prezentacji danych użytkownikowi,
– mechanizm DDM warto wykorzystywać głównie dla raportowania, odczytu danych oraz ograniczania dostępu do danych poufnych dla użytkowników biznesowych, audytorów czy pracowników wsparcia technicznego.


Rozważmy kolejny przypadek.

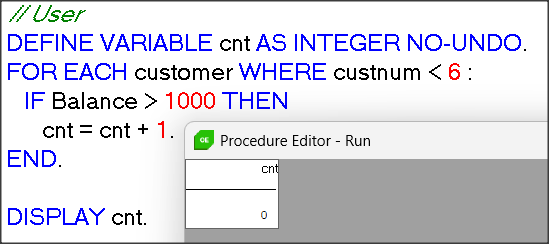
Admin uruchamia zapytanie dla 5 pierwszych rekordów Customer. Widać, że dwa z nich mają wartość pola Balance powyżej 1000.

A teraz uruchamiam poniższy program jako User.

Nie powinno nas dziwić, że licznik cnt wynosi zero ponieważ wartości pola Blanace są dla Usera zamaskowane i program widzi same zera.
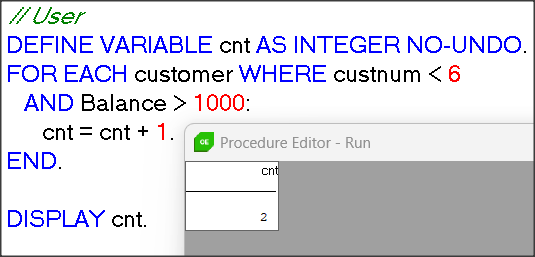
Ale co się dzieje w poniższym przykładzie?

Zmieniliśmy nieco logikę przesuwając warunek na pole Balance do otwarcia pętli (fraza WHERE) i licznik wychwytuje teraz te dwie wartości > 1000.

Możecie sprawdzić sami, że jeśli wyświetlilibyśmy teraz to pole w pętli to nadal byłoby zamaskowane.
Dlaczego tak się dzieje? Otóż tutaj filtrowanie jest wykonywane bezpośrednio przez silnik bazy danych przed zastosowaniem maskowania. Oznacza to, że rekord może zostać wybrany na podstawie rzeczywistej wartości Balance, mimo że użytkownik po odczycie nadal zobaczy wartość 0. I choć maskowanie nie pozwoli nam na poejrzenie wartości możemy dostać pewną informację na temat ilości klientów których saldo jest większe od określonej wartości. Jeśli zbiór danych nie jest duży to dość łatwo możemy zawęzić zakres wartości pola Balance dla poszczególnych klientów.

Samo maskowanie wartości często nie wystarcza, ponieważ liczba rekordów, wyniki agregacji czy czas wykonania zapytania również mogą ujawniać informacje o danych.
W praktyce oznacza to, że mechanizm DDM musi być projektowany razem z logiką aplikacji, a nie traktowany jako niezależna warstwa bezpieczeństwa.

Na zakończenie: nie tylko OpenEdge

Warto podkreślić, że opisane ograniczenia nie są specyficzne wyłącznie dla Dynamic Data Masking w Progress OpenEdge. Podobne ograniczenia mają również inne technologie tego typu dostępne na rynku.

To nie jest więc „bug” konkretnego rozwiązania, ale raczej naturalna cecha samego podejścia do maskowania danych. DDM ukrywa wartości pól, ale nie zawsze ukrywa informacje wynikające z działania aplikacji, zapytań czy agregacji.

Dlatego nawet jeśli użytkownik nie widzi danych bezpośrednio, nadal może czasem wyciągać pewne wnioski na podstawie:

– liczby rekordów,
– działania warunków,
– agregacji,
– sortowania,
itp.

W praktyce oznacza to, że Dynamic Data Masking warto traktować jako dodatkową warstwę ochrony danych, a nie jedyne zabezpieczenie systemu.

OpenEdge 13

10 lutego 2026 roku pojawiła się pierwsza wersja OpenEdge 13, jako tzw, Innovation Release, co stanowi przygotowanie pod wersję długoterminową (LTS). Platforma rozwijana przez Progress wchodzi na kolejny poziom nowoczesności. To wydanie skupia się przede wszystkim na zwiększeniu wydajności, bezpieczeństwa oraz lepszej integracji z nowoczesnymi technologiami w chmurze i kontenerowymi. Dla firm korzystających z OpenEdge oznacza to większą elastyczność, łatwiejsze skalowanie aplikacji oraz lepsze przygotowanie na przyszłe wyzwania technologiczne.

OpenEdge 13 to wydanie zaprojektowane z myślą o nowoczesnych wymaganiach biznesowych i technologicznych. Twórcy platformy położyli szczególny nacisk na bezpieczeństwo, dostępność, wydajność aplikacji oraz coraz ważniejsze obszary, takie jak sztuczna inteligencja i zaawansowane zarządzanie danymi.

Nowa wersja przynosi szereg usprawnień, które mogą realnie wpłynąć na funkcjonowanie systemów w organizacji – niezależnie od jej wielkości. OpenEdge konsekwentnie rozwija się jako platforma wspierająca modernizację istniejących aplikacji, jednocześnie przygotowując je na integrację z nowymi nowoczesnymi technologiami.

W praktyce OpenEdge 13 wprowadza zmiany, które przekładają się na codzienną pracę zespołów IT. Platforma zwiększa produktywność w całym swoim ekosystemie, usprawniając zarówno proces developmentu, jak i zarządzanie środowiskiem. Jednocześnie oferuje lepszą, zoptymalizowaną wydajność – zarówno na poziomie aplikacji, jak i operacji bazodanowych.

Istotnym kierunkiem rozwoju jest również otwarcie na rozwiązania oparte o sztuczną inteligencję. OpenEdge 13 tworzy fundamenty, które umożliwiają integrację aplikacji z ekosystemem AI, co staje się coraz ważniejsze w kontekście analityki i automatyzacji procesów biznesowych.

Nie bez znaczenia są także usprawnienia w obszarze bazy danych. Nowa wersja poprawia przepustowość oraz skraca czas działania narzędzi administracyjnych, co przekłada się na zmniejszenie czasu potrzebnego na konserwację systemu. Równocześnie wzmacnia fundamenty bezpieczeństwa, zapewniając solidne i zgodne ze standardami środowisko pracy.

Niektóre z wprowadzonych nowości możecie znać z wersji 12.8 gdzie były testowane.
Zacznijmy od wybranych nowości w administrowaniu bazy danych.

Wielowątkowe tworzenie kopii zapasowych

Skrócenie czasu wykonywania kopii zapasowych ma bezpośredni wpływ na ograniczenie okien serwisowych i zwiększenie dostępności systemu. W OpenEdge 13 wprowadzono mechanizm wielowątkowego backupu, który znacząco przyspiesza operacje tworzenia kopii zapasowych baz danych w trybie offline.

Tryb wielowątkowy został ustawiony jako domyślny zarówno dla backupów offline, jak i online. Dzięki temu system automatycznie wykorzystuje dostępne zasoby CPU, co przekłada się na krótszy czas realizacji operacji. W razie potrzeby zachowanie to można skonfigurować lub całkowicie wyłączyć za pomocą narzędzia PROBKUP.

probkup [baza] … [ -thread 0 | 1 ] [ -threadnum num-threads ]

Jeśli przed wykonaniem komendy pojawia sie ostrzeżenie ESAM to wynika to stąd, że po wyinstalowaniu poprzedniej wersji nie usunąłem katalogów ESAM.

Wielowątkowe sprawdzanie indeksów (offline)

Sprawdzanie indeksów to kluczowe narzędzie administracyjne wykorzystywane do oceny stanu bazy danych, identyfikacji problemów oraz zapewnienia integralności danych. Odgrywa również istotną rolę w planowaniu i realizacji strategii odzyskiwania po awariach.

W OpenEdge 13 rozszerzono to mechanizm o możliwość wielowątkowego sprawdzania indeksów w trybie offline. Administratorzy mogą teraz równolegle walidować rekordy dla poszczególnych kluczy oraz ich kolejność, co znacząco przyspiesza cały proces.

Zarówno w trybie online, jak i offline, operacje realizowane w ramach opcji 2, 3 i 4 wykorzystują domyślnie przetwarzanie wielowątkowe — pod warunkiem, że środowisko dysponuje odpowiednimi zasobami (CPU, pamięć oraz wydajny dostęp do dysku). Dzięki temu możliwe jest równoległe wykonywanie operacji, które wcześniej były realizowane sekwencyjnie.

proutil [baza] -C idxcheck [ -thread 0 | 1 ] [ -threadnum num-threads ]

Wprowadzono ulepszenia polecenia PROUTIL IDXCOMPACT, służącego do kompresji indeksów.
Jednym z nich jest parametr -compactonly — można jej używać do kompresji drzewa indeksu wyłącznie wtedy, gdy indeks jest unikalny. Opcja ta:
– wyłącza skanowanie drzewa w poszukiwaniu symboli zastępczych usuniętych wpisów indeksu, a zamiast tego przeprowadza jego kompresję;
– wpływa na działanie operacji IDXCOMPACT w zależności od tego, czy określono również opcję -unusedblocks
Aby dokładniej zrozumieć działanie operacji warto przeczytać w dokumentacji z jakich faz składa sie kompaktowanie indexów.

Format notacji naukowej w ABL
ABL obsługuje obecnie odczyt i zapis liczb w notacji naukowej, wykorzystywanej m.in. w formatach takich jak JSON czy XML. Taki zapis umożliwia reprezentowanie bardzo małych lub bardzo dużych wartości za pomocą notacji naukowej.

Dzięki tej funkcji programiści ABL mogą uprościć swój kod i zaoszczędzić czas, eliminując konieczność tworzenia dodatkowych procedur konwersji.

Należy podkreślić, że funkcja ta nie wprowadza nowego typu danych, lecz umożliwia przetwarzanie liczb zapisanych w notacji naukowej. Po ich odczytaniu wartości są nadal reprezentowane wewnętrznie jako jeden ze standardowych typów danych ABL: INTEGER, INT64 lub DECIMAL. W dokumentacji są podane ciekawe przykłady takich liczb, ale zobaczmy dla przykładu dwie poniższe wartości.

/* Średnica czerwonej krwinki człowieka w [m] */
VAR DECIMAL RedBloodCellDiameter = 7e-6.

/* Średnica wszechświata w [m] */
VAR DECIMAL UniverseDiameter = 8.8e26.

DISPLAY RedBloodCellDiameter FORMAT "9.99999E-99".
DISPLAY UniverseDiameter FORMAT "9.99999E+99".

PAUSE.

Przy wyświetlaniu ważne jest podanie formatu. Na takim zapisie można robić konwersję z wartości znakowych.

Pisałem w zeszłym roku o integracji OE Developr’s Studio z AI Coding Assistant. Wymagało to wykonania kilku czynności. W OpenEdge 13.0 to środowisko zawiera już zintegrowanego Asystenta Kodowania AI obsługiwanego przez ChatGPT.

Inną ważną informacją jest to, że platforma .NET 8 uzyskała certyfikat zgodności z OpenEdge 13.0 zarówno dla aplikacji ABL, jak i .NET Open Client. Certyfikat ten gwarantuje, że aplikacje ABL oraz .NET Open Client po aktualizacji do .NET 8 mogą korzystać z funkcji tej platformy, pozostając jednocześnie w ramach wspieranej wersji środowiska .NET.
.NET 8 jest wersją objętą długoterminowym wsparciem technicznym (LTS), którego zakończenie planowane jest na listopad 2026 roku (od 2023 r.).

Wprowadzono jak zawsze wiele ulepszęń w dziedzinie zabezpieczeń, np. wsparcie dla FIPS 140-3.
FIPS (Federal Information Processing Standards) to zestaw standardów opracowanych przez rząd USA, określających wymagania m.in. w zakresie bezpieczeństwa danych i stosowania algorytmów kryptograficznych.

W kontekście OpenEdge ich znaczenie polega na tym, że zapewniają zgodność z uznanymi normami bezpieczeństwa. Dzięki wsparciu FIPS system może korzystać wyłącznie z certyfikowanych, bezpiecznych mechanizmów kryptograficznych, co jest szczególnie istotne w środowiskach wymagających wysokiego poziomu ochrony danych (np. w instytucjach finansowych lub administracji).

Po więcej szczegółów zapraszam do dokumentacji.

Promon 4 – strojenie sieci

W środowisku aplikacji wielowarstwowej komunikaty sieciowe są nieustannie przesyłane pomiędzy klientami zdalnymi a serwerem bazy danych. Komunikacja sieciowa może stanowić potencjalne wąskie gardło, które negatywnie wpływa na wydajność systemu.
Podczas pracy bazy danych należy proaktywnie monitorować parametry komunikacji sieciowej. W przypadku zauważenia jej pogorszenia warto rozważyć dostrojenie odpowiednich parametrów, aby poprawić wydajność.

Aby skutecznie monitorować wydajność komunikacji w czasie, należy najpierw ustalić punkt odniesienia (baseline), obejmujący m.in.:
– czas reakcji operacji pobierania danych,
– liczbę komunikatów sieciowych wysłanych i odebranych w ramach pojedynczego zapytania.

Jeżeli w trakcie dalszego monitorowania zaobserwujesz wydłużenie czasu reakcji na zapytania lub istotny wzrost liczby wysyłanych i odbieranych komunikatów sieciowych, może to oznaczać konieczność dostrojenia parametrów komunikacji w celu przywrócenia optymalnej wydajności.

Podstawowym parametrem jest tutaj rozmiar komunikatu sieciowego, w którym przesyłane są rekordy -Mm. Jeśli zaobserwujesz wzrost liczby wysyłanych i odbieranych komunikatów sieciowych lub wydłużenie czasu odpowiedzi na zapytanie, warto rozważyć zwiększenie wartości parametru –Mm. Większy rozmiar bufora komunikatów pozwala przesyłać więcej rekordów w ramach mniejszej liczby komunikatów, co ogranicza fragmentację rekordów pomiędzy pakietami i może przełożyć się na poprawę czasu odpowiedzi. Zaleca się ustawić wartość -Mm na 8192 i taka wartość domyslna jest w OE 12.

Należy pamiętać, że aby zmienić rozmiar bufora komunikatów trzeba zamknąć serwer bazy danych.
Od wersji OpenEdge 11.6 w przypadku rozbieżności między ustawieniem parametru –Mm po stronie serwera i klienta, pierwszeństwo ma wartość określona na serwerze, a wartość po stronie klienta ustawi się automatycznie na taką samą jak na serwerze. We wcześniejszych wersjach OE sygnalizowany był błąd.

Kilka kolejnych parametró strojenia komunikacji sieciowej bazy danych zostało wprowadzonych w systemie OpenEdge w wersji OE 10.2B oraz 11.1. Ich celem jest poprawienie wydajności komunikacji sieciowej, szczególnie w dużych instalacjach.

Umożliwiają one precyzyjne dostrojenie mechanizmu pakowania komunikatów dla zapytań typu prefetch, a także regulację częstotliwości wywoływania funkcji systemowej poll().

Poniższe parametry uruchamiania bazy danych są dostępne wyłącznie w ramach licencji Enterprise i mogą być strojone online:

  • -prefetchDelay – po włączeniu tego parametru (nie ma on wartości) serwer przed wysłaniem do klienta pierwszego komunikatu sieciowego z pierwszym rekordem wypełnia go większą liczbą rekordów. Dzięki temu zmniejsza się liczba przesyłanych komunikatów, co przekłada się na lepszą wydajność. Włączając ten parametr trzeba ustawić przynajmniej jeden z dwóch poniższych, określających jak mają być wypełnione komunikaty.
  • -prefetchFactor – parametr ten określa stopień (w %) wypełnienia komunikatu przed wysłaniem go do klienta. Zalecaną wartością jest 100.
  • -prefetchNumRecs – określa liczbę rekordów umieszczanych w komunikacie przed jego wysłaniem przez sieć. Dopuszczalny zakres mieści się w przedziale od 1 do 32 766. Z reguły im więcej rekordów można umieścić w pojedynczym komunikacie, tym wydajniejsze jest ich pobieranie, co pozytywnie wpływa na ogólną wydajność bazy danych.
  • -prefetchPriority – To dość ciekawy parametr. Po ustawieniu powyższych parametrów typu prefetch, serwer działa domyślnie w następujący sposób: kopiuje pierwszy rekord zapytania do bufora komunikatów, a następnie sprawdza, czy inni użytkownicy zgłaszają jakieś żądania. Jest to tzw. mechanizm poll(). Jeśli nie ma innych żądań, serwer kopiuje kolejny rekord do bufora komunikatów i ponownie sprawdza kolejkę żądań. Jeśli pojawi się żądanie od innego użytkownika, serwer przetwarza je, wstrzymując tymczasowo obsługę zapytania prefetch. Po zakończeniu jego obsługi wraca do kopiowania kolejnych rekordów.

    Mechanizm poll() generuje stosunkowo duże obciążenie procesora systemowego. Z kolei samo kopiowanie rekordów zapytania do bufora komunikatów powoduje znacznie mniejsze obciążenie CPU.

    Z tego względu bardziej efektywne jest skopiowanie kilku lub więcej rekordów do bufora przed kolejnym sprawdzeniem nowych żądań użytkowników. W tym celu można użyć parametru –prefetchPriority, który określa liczbę rekordów prefetch dodawanych do bufora bez wywoływania mechanizmu odpytywania.

    Dzięki temu zapytanie prefetch zyskuje wyższy priorytet względem nowych żądań z innych połączeń zdalnych.

    Zastosowanie parametru –prefetchPriority pozwala zmniejszyć obciążenie procesora systemowego kosztem większego wykorzystania procesora po stronie użytkownika, co w praktyce może przełożyć się na poprawę ogólnej wydajności bazy danych. Dobrą wartością tego parametru jest 100.

  • -Nmsgwait – określa liczbę sekund, przez które serwer zdalny czeka na zdalny komunikat sieciowy przed sprawdzeniem innych zdarzeń, takich jak quiet point w bazie danych, wyłączenie (shutdown) lub wymuszone wyłączenie (forced shutdown) zdalnego klienta. Domyślna dobra wartości tego parametru wynosi 2 sekundy.

Parametry te możemy stroić w promonie: R&D -> 4. Administrative Functions -> 7. Server Options
Pamiętajmy, żeby wystartować serwer z parametrem -S [numer portu/nazwa serwisu]. Proces klienta też musi być wystartowany z parametrem -S.


Do monitorowania napiszmy procedurę zawierającą proste zapytanie do bazy sports2000, którą uruchamiamy z poziomu zdalnego klienta.

// timer.p
DEFINE VARIABLE i AS INTEGER NO-UNDO.

// Start stopera
i  = ETIME(YES).

FOR EACH customer NO-LOCK:
END.

// Złapanie czasu
i  = ETIME.
MESSAGE i " milisekund"
    VIEW-AS ALERT-BOX INFORMATION BUTTONS OK.

W celu monitorowania wchodzimy w promonie: R&D -> 2. Activity -> Servers
Najpierw naciskamy “z” żeby wyzerować liczniki, potem uruchamiamy procedurę i wreszcie naciskamu “u” dla uaktualnienia statystyk.

W menu ustawienia opcji serwera naciśnijmy 2 a następnie wartość 0, żeby wyłączyć opcję prefetch. Enabled zmieni się w Disabled. Uruchamiamy ponownie procedurę i uaktualniamy statystyki, jak poprzednio. Widzimy, że liczba komunikatów nieznacznie się zwiększyła, ale to w końcu proste zapytanie i niezbyt duża ilość rekordów.

Na koniec zmienię rozmiar parametru -Mm z 8192 do 1024 B. Robimy to oczywiście na zamkniętej bazie i powtarzamy test.

Widać wielokrotne zwiększenie liczby komunikatów. Czas wywołania procedury zwiększył się z 6 ms do ok. 20 ms. Ilość komunikatów rzadko kiedy zmienia się proporcjonalnie do rozmiaru -Mm. W końcu transfer sieciowy jest oparty o protokół tcp, a ten z kolei ma swoje mechanizmy i tzw. Maximum Transfer Unit, więc komunikaty z bazy mogą byc dzielone na mniejsze, ale znamy już podstawowe sposoby strojenia od strony OpenEdge’a.

Nowe typy extentów w bazach OpenEdge

Extenty są podstawowym elementem obszaru przechowywania (storage area) bazy danych OpenEdge. O ile bazę można podzielić na elementy logiczne jak tabele, indexy itp. to extenty są elementami fizycznymi – po prostu plikami na dysku.
Rozmiar, typ i lokalizację extentów definiuje się za pomocą pliku [nazwa_bazy].st.
Są dwa podstawowe typy extentów:

  • Extent stały (fixed extent) umożliwia kontrolę nad tym, ile miejsca na dysku przydzielić każdemu extentowi oraz ile extentów użyć. Przestrzeń w takich extentach jest sformatowana podczas tworzenia struktury bazy przez co wydajność zapisu do nich jest lepsza. Administrator musi jednak monitorować stopień wypełnienie danych.
  • Extent zmienny (variable extent) może przyrastać dynamicznie, stanowiąc taki “wentyl bezpieczeństwa” gdyby extenty stałe się zapełniły. Ułatwia to utrzymanie systemu, ponieważ nie trzeba regularnie monitorować rozmiaru extentów, ale powoduje spadek wydajności, gdyż OpenEdge RDBMS musi w trakcie zapisu do extentu zmiennego stale przydzielać i formatować przestrzeń.

    Co ważne, domyślnie ten typ extentu rośnie, aż osiągnie maksymalny rozmiar pliku dozwolony przez system operacyjny albo zajmie cały dysk lub system plików!
    Dlatego opcjonalnie można podać określony maksymalny rozmiar. Nie oznacza to jednak, że przestrzeń dla tego extentu jest przydzielona i sformatowana z góry (jak w przypadku extentu stałego). Po prostu rośnie on tylko do określonego rozmiaru.

Tak wygląda definicja przykładowych extentów w pliku .st bazy.

# extent stały
d "Cust_Data":9,32;1 . f 640
# extent zmienny z maksymalnym rozmiarem
d "Cust_Data":9,32;1 . v 1280

Wiadomo, że administrator powinien pilnować żeby dane w obszarze nie przekroczyły 80% jego objetości. Gdy sie to stannie należy dodać extenty stałe i oczywiście ostatni zmienny. Istniejący wtedy extent stały zmieni sie na stały ale jego rozmiar może być zupełnie inny od pozostałych zmiennych, często jest on bardzo mały jak extent .d3 na poniższym rysunku.

Nie jest to błędem ale po pewnym czasie możemy mieć wiele takich małych extentów w których będzie bardzo mało danych.
W OpenEdge 12 możemy temu zaradzić ponieważ dodano nowe tokeny do tworzenia i zarządzania zmiennymi extentami.

  • e rozszerza istniejący extent o zmiennej długości.
  • ev rozszerza istniejący extent o zmiennej długości i ustala maksymalny rozmiar.
  • x tworzy nowy, wstępnie rozszerzony extent o zmiennej długości.
  • xv tworzy nowy, wstępnie rozszerzony extent o zmiennej długości i ustala maksymalny rozmiar.

Np. w obszarze Cust_Data mamy dwa extenty, jeden stały i jeden zmienny jak poniżej.

Chcę dodać nowy extent zmienny z preformatowanym rozmiarem 320 kB i maksymalnym rozmiarem 640 kB, a istniejący zmienny zrobić preformatowany do wartości 320 kB. Extent ten będzie zamieniony na extent stały o określonej przez mnie długości. Plik t_add.st wygląda tak:

d "Cust_Data":9,32;1   t_9.d2   e   320  
d "Cust_Data":9,32;1   t_9.d3   xv  320  640

Uruchamiam komendę prostrct add z opcją -validate i jeśli format jest poprawny to ponownie ale już bez opcji -validate.


W pliku struktury t.st widać dodany extent. Extent .d2 ma tę samą długośc co .d1.

d "Cust_Data":9,32;1 C:\WrkOpenEdge128\db\t_9.d1 f 320
d "Cust_Data":9,32;1 C:\WrkOpenEdge128\db\t_9.d2 f 320
d "Cust_Data":9,32;1 C:\WrkOpenEdge128\db\t_9.d3 xv 320 640

A tak widać pliki w katalogu.

A gdy wylistujemy strukturę bazy poleceniem prostrct list [baza] > mylist.st mamy dodatkowe informacje:

...
   Area Name: Cust_Data, Type 6, Block Size 4096, Extents 3, Records/Block 32, Cluster Size 1
   Ext # 1, Type FIXED, Size 320 KByte, Name: ...\t_9.d1
   Ext # 2, Type FIXED, Size 320 KByte, Name: ...\t_9.d2
   Ext # 3, Type PRE-EXTENDED VARIABLE w/MAX SIZE, Size 320 KByte, Name: ...\t_9.d3
   ...

Obie wartości pre-extended i maksimum rozmiaru pliku możemy usunąć poleceniem:
prostrct add [baza] add.st gdzie plik add.st wygląda następująco:

d "Cust_Data":9,32;1   t_9.d3   ev   0  0

Pamiętajmy, że nie ma flagi v, więc nie można usunąć tylko tej drugiej wartości.

1 2 3 … 6